
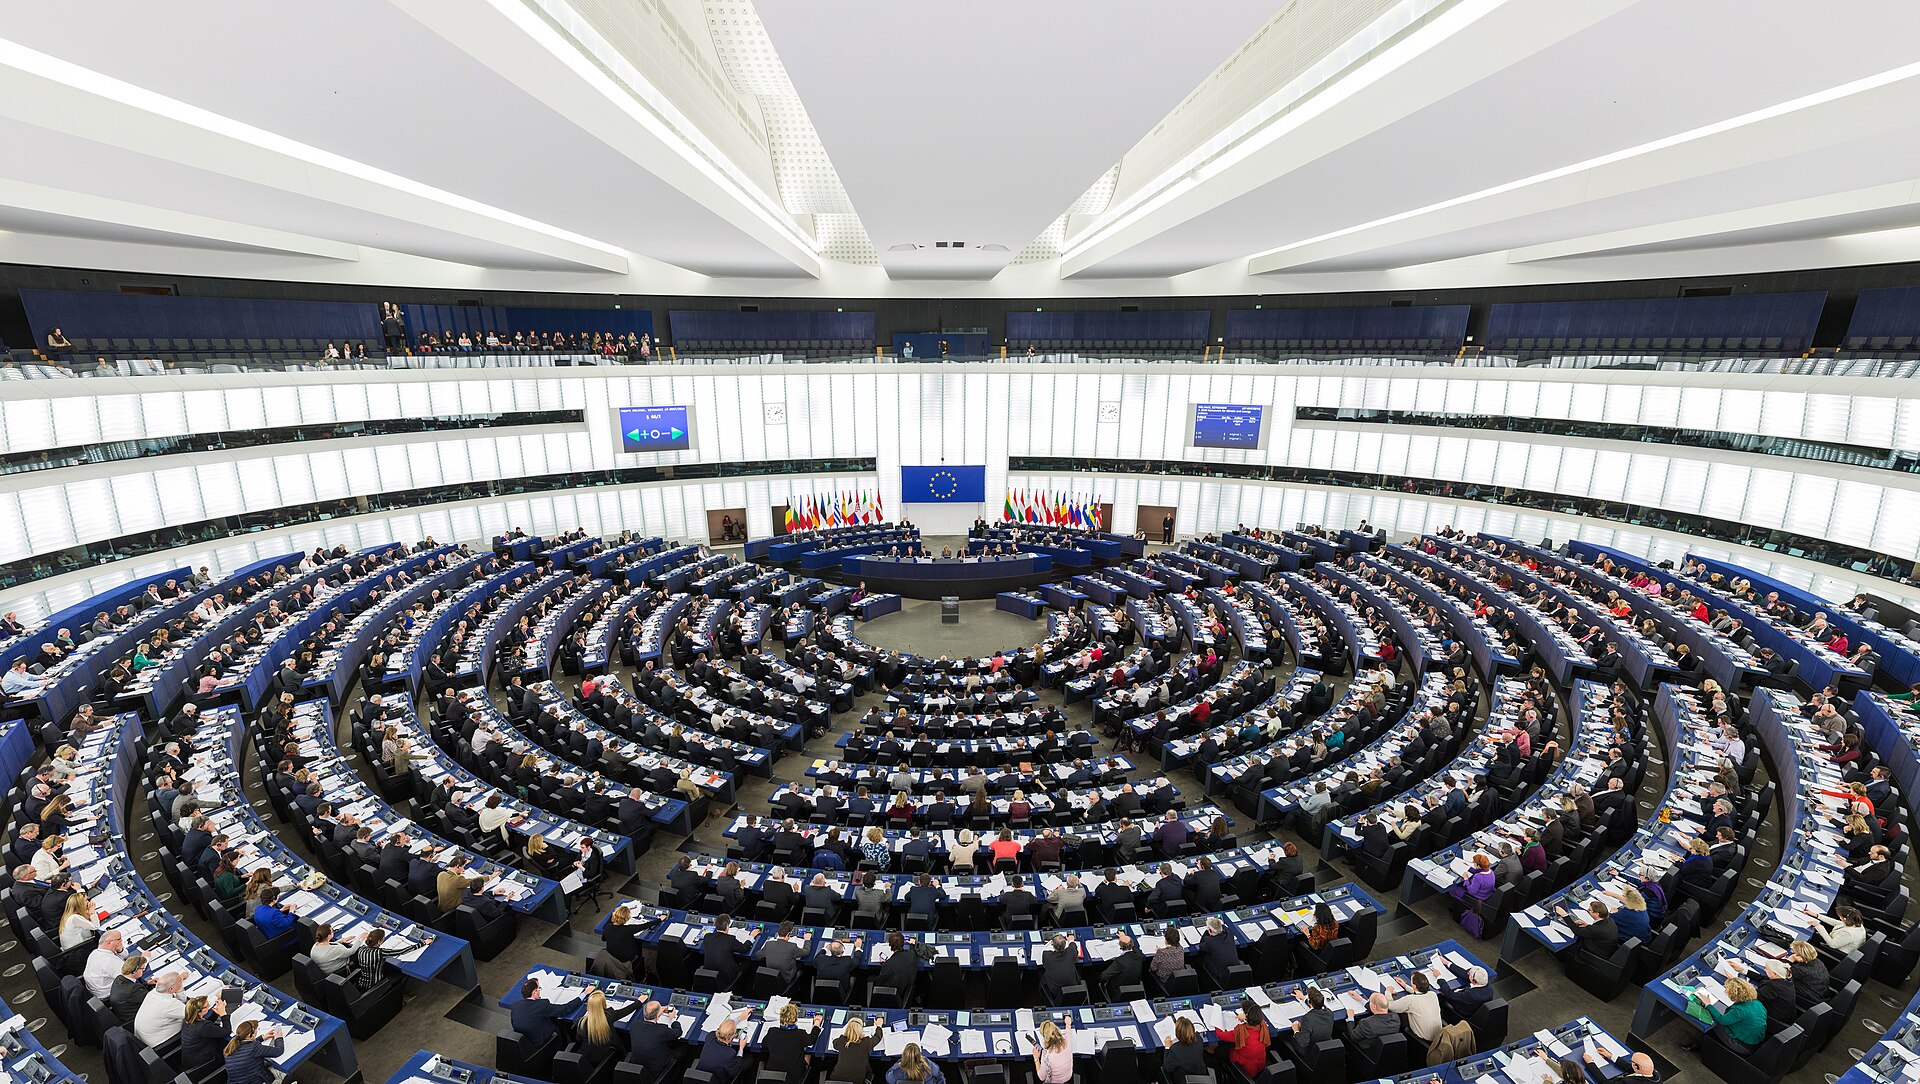
C'est ici, à Strasbourg, que les eurodéputés devront dire si nos données peuvent nourrir l'IA sans notre accord. Photo : Diliff, CC BY-SA 3.0, via Wikimedia Commons.
On nous l'a vendu comme un grand ménage administratif. En réalité, l'Europe s'apprête à céder ce qu'elle avait de plus précieux face aux géants du numérique : le droit de dire non. Sous le nom anodin d'« omnibus numérique », Bruxelles prépare une réforme qui permettrait d'entraîner et de faire tourner des intelligences artificielles avec nos données personnelles, sans nous demander notre avis. Et l'on apprend maintenant qui a soufflé les mots à l'oreille des décideurs. Ce n'est pas vous. Ce sont Google, Meta et leurs amis.
Ce qui s'est passé
Mercredi 28 octobre, deux associations spécialisées dans la surveillance du lobbying, Corporate Europe Observatory, basée à Bruxelles, et l'allemande LobbyControl, ont publié un rapport au titre sans détour : « La campagne de Big Tech pour tuer la protection des données en Europe ». Leurs chiffres sont tirés des registres publics. Au Parlement européen, elles ont compté 655 réunions de lobbying consacrées à l'omnibus numérique depuis que la Commission européenne a présenté le texte, en novembre 2025. Cela fait en moyenne trois rendez-vous avec des eurodéputés chaque jour ouvré.
Le déséquilibre saute aux yeux. 83 % de ces réunions représentaient des intérêts économiques. Seules 11 % ont eu lieu avec des associations ou des syndicats. Google arrive en tête des entreprises avec 21 réunions, Meta suit avec 19, sans compter les fédérations professionnelles qui parlent en leur nom, comme DIGITALEUROPE, présente à 10 rendez-vous.
Une semaine plus tôt, le mercredi 21 octobre, les gouvernements des Vingt-Sept, réunis au sein du Conseil de l'Union européenne, avaient adopté leur position de négociation sur le volet « données » de cette réforme. Le texte touche au RGPD, le règlement général sur la protection des données en vigueur depuis 2018, mais aussi aux règles sur les cookies, au règlement sur les données et à la directive sur la cybersécurité. Le Parlement européen doit maintenant arrêter sa propre position, attendue début 2027. Ensuite seulement, les deux institutions négocieront le texte final.
Ce que contient vraiment l'omnibus
Le cœur de la bataille tient en deux mots juridiques : « intérêt légitime ». Aujourd'hui, une entreprise qui veut utiliser vos données doit, dans bien des cas, obtenir votre consentement. La réforme permettrait aux développeurs d'IA de s'appuyer sur leur intérêt légitime pour entraîner et faire fonctionner leurs systèmes avec des données personnelles. Il leur suffirait de montrer que l'usage est nécessaire et qu'il ne l'emporte pas sur vos droits. C'est l'entreprise qui fait elle-même cette pesée. Vous n'êtes plus consulté, au mieux vous pourrez protester après coup.
Le Conseil a, il faut le reconnaître, retiré le pire. La définition des données personnelles reste intacte, alors que la Commission voulait la resserrer. Les autorités européennes de protection des données, le CEPD et le Contrôleur européen, avaient demandé noir sur blanc de « ne pas adopter les modifications proposées à la définition des données à caractère personnel ». Elles ont été entendues sur ce point. Le texte prévoit aussi des garanties pour l'usage de données sensibles dans la vérification biométrique et le développement de l'IA.
Mais le reste glisse dans le même sens. De nouvelles règles sur les données pseudonymisées, c'est-à-dire où le nom est remplacé par un code, pourraient sortir une partie de ces informations du champ du RGPD. Le délai pour signaler une fuite de données serait allongé. Et les cas où un site peut déposer des traceurs sans votre accord seraient élargis, notamment pour la mesure d'audience. On nous promet moins de bannières de cookies. On oublie de préciser que la bannière disparaît parce qu'on ne vous pose plus la question.
Berlin, Dublin, Strasbourg : la carte d'une influence
Le rapport ne s'arrête pas au Parlement. Il pointe deux capitales clés. En Allemagne, qui pèse le plus lourd dans les votes du Conseil, des entreprises technologiques non européennes ont participé à 103 réunions avec des membres du gouvernement depuis l'arrivée du chancelier Friedrich Merz, soit une et demie par semaine en moyenne. Le chancelier a lui-même rencontré les patrons d'Apple et d'OpenAI. Son ministre du Numérique, Karsten Wildberger, qui pilote le dossier, a tenu 18 réunions avec de grands groupes du secteur. Et le vrai chiffre est sans doute plus élevé, puisque Berlin ne publie pas systématiquement ces rendez-vous.
En Irlande, pays qui préside actuellement le Conseil et où Meta et Google ont leur siège européen, le registre national du lobbying montre que Meta a approché 41 responsables publics et eurodéputés, Google 30. Les auteurs du rapport relèvent aussi des allers-retours troublants entre administration et industrie : en Suède, au Danemark et en Irlande, d'anciens fonctionnaires ou responsables publics sont devenus lobbyistes pour Meta sur ce texte.
Au Parlement, la porte tourne dans l'autre sens. L'eurodéputée finlandaise Aura Salla, du groupe de centre droit PPE, a dirigé le lobbying de Meta à Bruxelles jusqu'en 2023. Elle est aujourd'hui rapporteure de l'omnibus pour la commission de l'industrie, donc l'une des principales négociatrices du Parlement, et c'est l'eurodéputée qui a reçu le plus de lobbyistes sur ce dossier : 110. Sept organisations, dont les deux auteures du rapport, ont demandé qu'elle soit remplacée. Elle conteste tout conflit d'intérêts et affirme avoir respecté les règles de transparence. Dont acte. Mais une démocratie ne devrait pas avoir à croire sur parole celle qui défendait hier les intérêts d'une entreprise et qui écrit aujourd'hui les règles qui la concernent.
Pourquoi c'est grave
Bram Vranken, chercheur à Corporate Europe Observatory, résume l'enjeu sans précaution oratoire : « Nos recherches montrent que Big Tech bénéficie d'un accès sans précédent aux plus hauts niveaux de gouvernement en Europe » (traduit de l'anglais). Il va plus loin sur le fond du texte : « Ce que nous voyons, c'est la création d'une énorme porte dérobée, qui dans de nombreux cas rendra le RGPD vide de sens. »
Felix Duffy, de LobbyControl, vise directement Berlin : « Le gouvernement allemand s'est rangé du côté des entreprises de l'IA. Le ministre du Numérique Wildberger a repris des revendications clés du lobby de l'IA : nos données personnelles seront disponibles pour l'IA. Les principaux bénéficiaires sont Google, Meta et OpenAI, pas les entreprises européennes. »
Cette dernière phrase devrait faire réfléchir à Paris. Le RGPD est l'une des rares lois européennes que le monde entier a copiées. Il dit une chose simple : vos données vous appartiennent, et on ne s'en sert pas sans raison claire. Quand une IA est entraînée sur vos messages publics, vos photos, vos avis ou votre historique, ce n'est pas un détail technique. C'est votre vie qui devient une matière première. Et les associations rappellent ce que cela peut nourrir : la reconnaissance faciale, les fausses images dénudées, les campagnes de désinformation. Retirer le consentement de l'équation, c'est retirer au citoyen son seul levier.
L'argument d'en face
Il mérite d'être entendu. L'Europe accuse un retard réel sur l'IA face aux États-Unis et à la Chine. Les entreprises européennes, surtout les plus petites, se plaignent depuis des années d'un empilement de règles coûteuses et floues. Dès novembre 2025, la France et l'Allemagne avaient salué le projet, jugeant que les textes actuels entraînent des « coûts disproportionnés et une insécurité juridique qui portent atteinte à la capacité de croissance et d'innovation des entreprises européennes ».
La présidence irlandaise défend un équilibre. Sa ministre des Affaires étrangères, Helen McEntee, affirme que la réforme facilitera l'activité des entreprises en Europe « en réduisant les charges administratives tout en maintenant des normes élevées en matière de protection des données et de droits des citoyens » (traduit de l'anglais). L'industrie, elle, trouve même que le Conseil n'est pas allé assez loin : DIGITALEUROPE estime que les États ont abordé les bons sujets « sans réellement résoudre les problèmes sur le terrain », et chiffre à 815 milliards d'euros d'ici 2030 le potentiel de l'économie européenne des données.
Tout cela n'est pas absurde. Personne ne regrettera les bannières de cookies qui s'empilent sur chaque page. Une PME qui passe des semaines à remplir des formulaires de conformité a raison de protester. Et le Conseil a ajouté un garde-fou intéressant : les organismes publics pourraient faire payer plus cher la réutilisation de leurs données aux très grandes plateformes, les fameux « contrôleurs d'accès » désignés par le droit européen.
Mais il y a un tour de passe-passe. On invoque les PME pour justifier une réforme dont les premiers bénéficiaires sont des géants américains qui disposent déjà des plus grandes réserves de données au monde. Simplifier un formulaire, oui. Supprimer le consentement pour entraîner des IA, c'est autre chose. Ce n'est pas de la simplification, c'est un transfert de pouvoir. Et les 127 syndicats et associations qui ont protesté dès la présentation du texte l'avaient dit : la « simplification technique » affichée « est en réalité une tentative de démanteler secrètement les plus fortes protections de l'UE contre les menaces numériques ».
Notre position
Nous ne sommes pas contre l'IA, ni contre une Europe qui innove. Nous sommes contre une règle écrite pour ceux qui ont le plus d'argent pour la faire écrire. Quand 83 % des voix entendues par les élus viennent des entreprises, le résultat n'est pas une loi équilibrée. C'est une loi sur mesure.
La liberté numérique commence par une idée très ancienne : ce qui est à moi ne peut pas m'être pris sans mon accord. Nos données personnelles disent où nous allons, ce que nous lisons, qui nous aimons, ce que nous pensons. Les livrer à des modèles d'IA sur la seule foi d'un « intérêt légitime » évalué par l'entreprise elle-même, c'est confier la clé de la maison à celui qui veut entrer, en le laissant juger seul s'il a une bonne raison de le faire.
La France a d'ailleurs un rôle particulier à jouer. Elle a soutenu la réforme dès le départ au nom de la compétitivité. Elle peut encore, avec ses eurodéputés, peser pour que la simplification profite aux PME sans sacrifier les citoyens. Le Parlement européen a montré cette année, sur le scan des messages privés, qu'il savait tenir tête aux gouvernements. Il doit recommencer.
Le RGPD n'est pas parfait. Il est lourd, parfois mal appliqué, et les grandes plateformes ont appris à le contourner. Mais la réponse à une loi mal appliquée, c'est de mieux l'appliquer, pas d'ouvrir les vannes. Une fois nos données avalées par des modèles d'IA, il n'y aura pas de bouton « retour ».
Ce que nous demandons
- Le consentement pour entraîner une IA sur nos données. Les eurodéputés doivent supprimer la possibilité d'utiliser l'intérêt légitime pour entraîner et faire tourner des systèmes d'IA avec des données personnelles, ou au minimum exclure toutes les données sensibles et garantir un droit d'opposition simple, en un clic, avant tout usage.
- Une rapporteure sans lien avec l'industrie concernée. Le Parlement européen doit confier le dossier, pour la commission de l'industrie, à un élu qui n'a pas travaillé pour une entreprise directement visée par le texte, et publier l'agenda complet de tous les négociateurs sur l'omnibus.
- La transparence du gouvernement français. Paris doit publier la liste des rendez-vous de ses ministres et de ses négociateurs avec les entreprises du numérique sur ce dossier, et dire clairement si la France défend, oui ou non, l'IA sans consentement.
Et vous, accepteriez-vous que vos photos, vos messages publics ou votre historique servent à entraîner une IA sans qu'on vous le demande ? Dites-nous en commentaire.
Sources des citations (traduites de l'anglais par nos soins sauf mention) : Bram Vranken et Felix Duffy (EU Perspectives et EUobserver, 28 octobre 2026) ; Helen McEntee et DIGITALEUROPE (EU Perspectives, 28 octobre 2026) ; communiqué franco-allemand, 127 organisations et avis du CEPD (Refrance, 26 octobre 2026, citations en français) ; rapport de Corporate Europe Observatory et LobbyControl (28 octobre 2026).
#parolelibre #vieprivee #rgpd #bigtech #intelligenceartificielle

Un point de contexte : l'intérêt légitime pour l'IA n'arrive pas avec l'omnibus. Dans son avis 28/2024 du 17 décembre 2024, le CEPD admettait déjà qu'il peut servir de base pour développer un modèle d'IA, à condition de passer un test en trois étapes : un intérêt réel et licite, un traitement vraiment nécessaire, puis une mise en balance avec les droits des personnes. L'omnibus l'inscrirait noir sur blanc dans le texte, ce qui laisserait moins de marge aux autorités pour juger au cas par cas.
On a déjà vu ce que donne ce modèle avec Meta : depuis le 27 mai 2025, l'entreprise entraîne ses IA sur les publications publiques de ses utilisateurs adultes européens, au nom de l'intérêt légitime, avec un formulaire d'opposition (article 21 du RGPD). Mais selon les autorités de protection des données, cette opposition ne vaut que pour l'avenir : les contenus déjà utilisés avant qu'on ne s'y oppose restent dans l'entraînement. Cela rejoint votre point, il n'y a pas de bouton « retour ».